Ein KI-Stimmengenerator macht aus geschriebenem Text eine Sprachaufnahme. Für den Einstieg brauchst du einen kurzen Text und eine passende Standardstimme. Entscheidend ist, ob Aussprache, Export und Nutzungsrechte zu deinem Vorhaben passen.
Vier KI-Stimmengeneratoren im Vergleich
Für ein Erklärvideo brauchst du einen anderen Arbeitsweg als für eine Anwendung mit genauer Pausensteuerung. Diese vier Werkzeuge decken unterschiedliche Aufgaben ab. Die Funktionen sind anhand der Herstellerdokumentation verglichen; ein gemeinsamer Klangtest der Anbieter liegt noch nicht vor.
ElevenLabs
Für deutsche Sprechertexte. Wähle eine Stimme und ein Modell, das Deutsch unterstützt. Welche Sprachen und Steuerungen verfügbar sind, hängt vom Modell ab.
Vor dem Einsatz prüfen: Downloadformat und Lizenz. Der Free-Tarif enthält keine kommerzielle Lizenz.
Murf Studio
Für Voiceover mit Bearbeitung im Editor. Murf beschreibt Anpassungen für Tempo, Pausen und Aussprache.
Vor dem Einsatz prüfen: Welche Vorschau, Downloads und Nutzungsrechte dein Plan umfasst.
Azure
Für Text und SSML mit Azure-Zugang. Audio Content Creation bietet Vorschau, Anpassung und Export. SSML ist eine Auszeichnungssprache, etwa für Pausen oder Aussprache.
Du brauchst die passende Speech-Ressource beziehungsweise ein Foundry-Projekt. Nicht jede Stimme unterstützt jedes SSML-Element.
stimmen.ai
Für einen einzelnen deutschen Sprachauftrag. Du kannst eine Vorschau anhören und eine MP3 mit Audio-Wasserzeichen testen.
Für die finale Datei prüfst du den Auftragspreis und den erlaubten Nutzungsumfang vor dem Kauf.
Noch unsicher? Einstieg nach Aufgabe finden
Vergleiche dieselbe kurze deutsche Probe. Stimme, Export und Rechte prüfst du im konkreten Tarif.
Zur Anbieter-Auswahl →Diese Hilfe schlägt einen Arbeitsweg vor. Sie erzeugt keine Audiodatei.
Was kostet die fertige Datei?
| Zugang | Einstieg | Nutzung prüfen |
|---|---|---|
| ElevenLabs | Free: 0 US-Dollar und 10.000 Credits pro Monat. Starter: regulär 6 US-Dollar pro Monat, 30.000 Credits. | Free ohne kommerzielle Lizenz; nichtkommerzielle Veröffentlichung mit geforderter Attribution. Bezahlte Nutzung unter Bedingungen, unter anderem Eingaberechte; Beta-Dienste sind ausgenommen. |
| Murf | Planabhängiger Zugang; keinen ungeprüften Einheitspreis ansetzen. | Aktuelle Download-, Mengen- und Nutzungsrechte im konkreten Plan kontrollieren. |
| Azure | Keine zusätzliche Gebühr nur für das Audio-Content-Creation-Werkzeug; Speech-Nutzung wird gesondert abgerechnet. | Verbrauch, Ressource, Stimme und gegebenenfalls zusätzliche Dienste berücksichtigen. |
| stimmen.ai | Laut Anbieter kostenlose MP3-Vorschau mit Audio-Wasserzeichen; final ab 30 Euro netto für bis zu 500 Zeichen, je weitere 500 Zeichen 10 Euro netto. | Konkreten Preis und Nutzungsumfang vor dem finalen Auftrag bestätigen. |
Vorhören, Herunterladen und Veröffentlichen sind drei verschiedene Dinge. Prüfe vor einem längeren Text, was dein Zugang tatsächlich erlaubt.
Quellen: ElevenLabs-Tarife und Veröffentlichungshilfe. Aktions- und Jahrespreise können vom regulären Monatspreis abweichen. Credits verschiedener Anbieter entsprechen nicht automatisch derselben Audiolänge.
Lieber lokal arbeiten?
Für einen Apple-Silicon-Mac zeigt der Guide zu Ollama Phonon für lokale Sprachausgabe einen deutschen Einstieg. Beachte die eigenen Bedingungen des deutschen Checkpoints.
Kokoro TTS ist ein weiterer technischer Einstieg; unser Guide beginnt mit einem englischen Voicepack. Ein dort offiziell belegter deutscher Standardzugang liegt uns nicht vor.
Wenn du mehrere Werkzeuge ausprobieren willst, hilft dir der Ablauf zum Vergleichen von KI-Werkzeugen an derselben Aufgabe.
Als Nächstes hörst du, welche Stellen einer deutschen Probe sich zum Gegenprüfen eignen.
Deutsche Hörproben anhören
Hier folgen drei eigene, lokal mit Piper erzeugte Hörproben. Sie sind kein Hörtest der vier oben verglichenen Anbieter. Höre dieselben Stellen an und prüfe neben dem Klang insbesondere Datum, Preis und Fachbegriffe.
Der Text für alle Hörproben
Fiktiver Sprechtext · unverändert für alle drei Originalproben
Die fiktive offene Werkstatt beginnt am 5. November um 18 Uhr. Ein Adapter kostet 3,50 Euro. Wir prüfen eine API, einen MCP-Zugang und ein lokales KI-Modell. Die Teilnahmegebühr ist noch unbekannt.- 5. November · 18 UhrDatum und Uhrzeit bleiben erhalten.
- 3,50 EuroDer Betrag gehört zum Adapter.
- API · MCP · KIDie Abkürzungen sind verständlich.
- Gebühr unbekanntAus der offenen Angabe wird kein Preis.
Eine Probe, zwei Stimmen, drei Modellvarianten
Diese Dateien haben wir am 26.10.2026 lokal mit Piper erzeugt. Thorsten medium und high verwenden dieselbe Stimme in zwei Modellvarianten; Kerstin ist eine andere Stimme. „Low“, „medium“ und „high“ sind Modellbezeichnungen.
Die Aufnahmen stammen von Piper, nicht von den vier Anbietern aus dem Vergleich.
Messwerte und Erzeugung der Hörproben
| Modell | Länge | WAV-Abtastrate | Web-Datei |
|---|---|---|---|
| Thorsten · medium | 13,63 s | 22050 Hz | 107,2 KiB |
| Kerstin · low | 14,8 s | 16000 Hz | 116,8 KiB |
| Thorsten · high | 13,42 s | 22050 Hz | 105,6 KiB |
Jede Originalprobe wurde einmal mit demselben Text erzeugt. Einstellungen: length_scale 1,0; noise_scale 0,667; noise_w_scale 0,8. Die Aufnahmen wurden nicht geschnitten oder im Tempo verändert; die Web-Dateien sind als MP3 komprimiert.
Die Tabelle enthält Dateimessungen, keine Aussprachebewertung. Ein menschliches Hörpanel wurde nicht durchgeführt. Die MODEL_CARD-Dateien nennen CC0 für die zugrunde liegenden Datensätze; Laufzeit, Modelle und Quelldaten sind getrennte Lizenzebenen.
Versuchsmanifest mit Texten, Einstellungen und Prüfsummen · Dateimessungen als CSV
Nimm denselben Text jetzt als Ausgangspunkt für deine eigene erste Datei.
Deine erste Audiodatei erstellen
Beginne mit einer kurzen Probe. Eine vorhandene Standardstimme genügt; einen Klon brauchst du dafür nicht. So merkst du früh, ob die Aussprache und der Export zu deinem Vorhaben passen.
- Text festlegen
Kopiere die Probe oben oder verwende einen kurzen eigenen Text. Notiere die Fakten, die unverändert bleiben müssen.
- Stimme und Modell wählen
Wähle Deutsch und eine passende Standardstimme. Halte Modellname, Stimme und Einstellungen fest.
- Eine Fassung erzeugen
Prüfe das Kontingent und starte die kurze Probe. Höre anschließend den ganzen Text, einschließlich Anfang und Ende.
- Eine Stelle korrigieren
Ändere zunächst nur Text, Tempo oder eine andere Einstellung. So kannst du die Wirkung der Korrektur nachvollziehen.
- Datei exportieren
Lade die fertige Datei herunter und öffne sie außerhalb des Anbieters, etwa in deinem Video- oder Audioprogramm.
Die ElevenLabs-Anleitung für deutsche Sprechertexte zeigt den Browserweg mit Modellwahl, Aussprache und Download.
So unterscheidet sich der Azure-Ablauf
In Audio Content Creation gibst du Text oder SSML ein, wählst Sprache und Stimme, hörst die Vorschau und passt sie an. Im Foundry-Portal brauchst du das passende Projekt; Speech Studio verwendet die ausgewählte Speech-Ressource.
Nach dem Speichern folgt der Export als eigener Auftrag. Warte auf dessen Abschluss und prüfe die heruntergeladene Datei. Für diesen Artikel wurde keine Azure-Synthese ausgelöst.
Wenn Zahlen oder Wörter falsch klingen
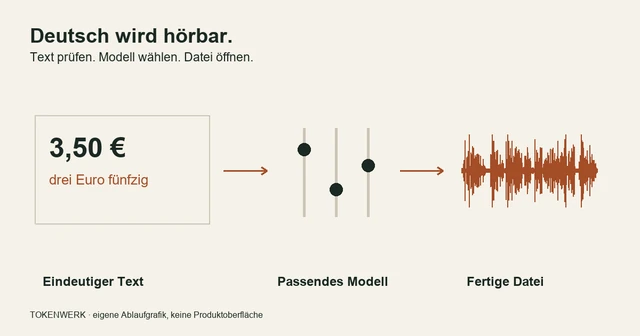
Schreibe eine problematische Zahl versuchsweise aus. Behalte Stimme, Modell und Tempo bei. Für unser Beispiel sieht die Änderung so aus:
Ausgeschriebene Fassung · gleiche Angaben
Die fiktive offene Werkstatt beginnt am fünften November um achtzehn Uhr. Ein Adapter kostet drei Euro fünfzig. Wir prüfen eine API, einen MCP-Zugang und ein lokales KI-Modell. Die Teilnahmegebühr ist noch unbekannt.Thorsten · medium · ausgeschriebene Fassung
13,2 Sekunden · 104 KiB · MP3, mono, 64 kbit/s
Für diese zusätzliche Piper-Aufnahme blieben Modell und Einstellungen gleich. Verändert wurde nur die Textfassung. Die Synthese kann trotzdem variieren; nicht jeder hörbare Unterschied lässt sich allein auf die Schreibweise zurückführen.
Beide Fassungen müssen 5. November, 18 Uhr und 3,50 Euro wiedergeben. Die Teilnahmegebühr bleibt unbekannt.
Pausen kannst du zunächst mit Zeichensetzung beeinflussen. Für genauere Steuerung nutze nur die dokumentierten Möglichkeiten deiner Stimme. SSML-Tags oder Regieanweisungen funktionieren nicht bei jedem Modell gleich; sie können auch mitgesprochen werden.
Wenn die Probe passt, prüfst du noch die exportierte Datei und ihre Nutzung.
Die fertige Datei prüfen und verwenden
Für dein Video oder deine Lernlektion brauchst du die Audiodatei. Ob WAV oder MP3 passt, hängt vom Zielprogramm und den verfügbaren Exportformaten ab.
Vier Punkte vor der Veröffentlichung
- Inhalt: Zahlen, Namen und offene Angaben sind richtig gesprochen.
- Vollständigkeit: Anfang, Ende und alle Sätze sind in der exportierten Datei enthalten.
- Verbrauch: Du kennst das verwendete Kontingent und die Kosten weiterer Fassungen.
- Nutzung: Der Tarif und die Rechte an Text und Stimme decken deinen vorgesehenen Zweck ab.
Deinen Hörvergleich festhalten
Notiere bei jedem Kandidaten die konkrete auffällige Stelle, etwa „Betrag falsch“ oder „Pause zu lang“. Verwende dieselbe Textfassung und dieselbe Wiedergabeumgebung. Eine pauschale Klangnote erklärt dir später nicht, was du ändern musst.
Vergleichsblatt als CSV · Sprechprobe mit Prüfprotokoll als TXT
Eigenen Text auf mögliche Stolperstellen prüfen
Füge deinen Text ein und markiere mögliche Stolperstellen. Der Text bleibt in diesem Tab; es wird kein Audio erzeugt.
Der Check zählt Zeichen und markiert Zahlen, Abkürzungen sowie ausgewählte offene Angaben. Er analysiert keine Aufnahme und bestätigt keine Fehlerfreiheit.
Audiodatei und Stimmenklon sind verschieden
Eine exportierte MP3 enthält das gesprochene Ergebnis. Sie ist kein Stimmenmodell, das du lokal weiterbetreiben kannst. Nach der ElevenLabs-Cloning-Hilfe lässt sich der dort gehostete Klon nicht als eigenständige Modelldatei herunterladen.
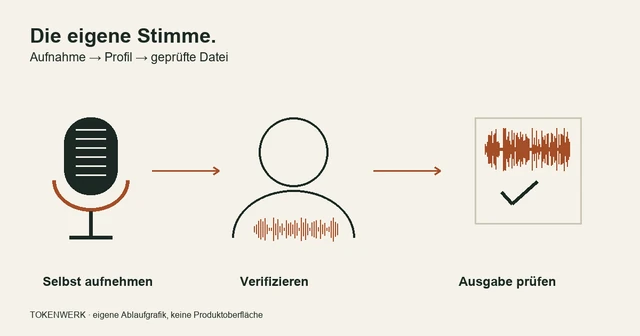
Wenn du ausdrücklich deine eigene Stimme verwenden willst, zeigt der Leitfaden Aufnahme, Verifizierung und Abnahme eines Stimmenklons. Prüfe vor einem Upload auch private Daten in deinem Material.
Quellen & Methode
Vorgehen und Grenzen
Vier aktuelle Vollquellen zur Suchintention wurden am 26.10.2026 ausgewertet; Produktangaben zusätzlich mit Herstellerdokumentation geprüft. Eigenes Hörlabor: drei lokale Piper-Modellproben und eine ausgeschriebene Textvariante, erzeugt am 26.10.2026 mit Piper 1.3.0. Dauer, Format und Dateigröße wurden gemessen; kein menschliches Hörpanel, kein Anbieter-Klangranking und kein eigener Stimmenklon. Die vier Cloud-/Browseranbieter wurden nicht praktisch synthetisiert. Die Auswahlhilfe und der Textcheck arbeiten ausschließlich in diesem Tab.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.
Belege für die Aussagen
- ElevenLabs: Text to Speech
- ElevenLabs: Instant Voice Cloning
- Microsoft: Sprachsynthese im Überblick
- Microsoft: Audio Content Creation
- ElevenLabs: aktuelle Tarife
- ElevenLabs: erzeugte Inhalte veröffentlichen
- Murf: Text to Speech
- stimmen.ai: Produkt und Preise
- Piper: lokale Sprachsynthese und CLI
- Piper MODEL_CARD: Thorsten · medium
- Piper MODEL_CARD: Kerstin · low
- Piper MODEL_CARD: Thorsten · high
Häufige Fragen
Welcher KI-Stimmengenerator eignet sich für deutsche Texte?
ElevenLabs, Murf, Azure Audio Content Creation und stimmen.ai sind dokumentierte Kandidaten für unterschiedliche Aufgaben. Wähle nach Voiceover, Bearbeitung, Azure-/SSML-Ablauf oder Einzelauftrag. Welche Stimme für deinen Text überzeugend klingt, musst du mit derselben deutschen Sprechprobe prüfen.
Kann ich KI-Stimmen kostenlos kommerziell nutzen?
Nicht pauschal. ElevenLabs Free enthält laut Veröffentlichungshilfe keine kommerzielle Lizenz; für nichtkommerzielle Veröffentlichungen wird eine Attribution verlangt. Bei allen Anbietern müssen Download, Tarif, Eingaberechte und der konkrete Nutzungszweck zusammenpassen.
Stammen die Hörproben von den verglichenen Anbietern?
Nein. Die vier Anbieter sind anhand ihrer Dokumentation verglichen. Die Hörproben wurden lokal mit Piper erzeugt: zwei Modellvarianten von Thorsten, eine Kerstin-Aufnahme und eine ausgeschriebene Textvariante. Dateimessungen sind dokumentiert; ein gemeinsamer Anbieter-Klangtest liegt nicht vor.
Wie korrigiere ich eine falsch ausgesprochene Zahl?
Teste zunächst eine ausgeschriebene Fassung, beispielsweise „drei Euro fünfzig“ statt „3,50 Euro“. Behalte Stimme und übrige Einstellungen bei. Höre den ganzen Satz erneut an und prüfe, ob die Bedeutung erhalten blieb.
Brauche ich einen Stimmenklon?
Nein. Für den ersten Sprechertext genügt eine vorhandene, für deinen Zweck erlaubte Standardstimme. Cloning ist ein zusätzlicher Vorgang mit eigenen Aufnahme-, Rechte- und Einwilligungsanforderungen.
Kann ich eine geklonte ElevenLabs-Stimme als Modell herunterladen?
Nach der gelesenen Cloning-Hilfe nicht als eigenständige Modelldatei. Der gehostete Clone bleibt im Konto. Der Export einer erzeugten MP3- oder WAV-Datei ist davon zu unterscheiden.
Welches Audioformat soll ich exportieren?
Richte dich nach dem Zielprogramm und den im gewählten Zugang verfügbaren Formaten. Prüfe die heruntergeladene Datei vollständig. Eine höhere Abtastrate beweist keine korrekte Aussprache und ein erfolgreicher Download keinen vollständigen letzten Satz.
Überträgt der Textcheck meinen Sprechtext an einen Anbieter?
Nein. Die ergänzende Auswahlhilfe und der Textcheck arbeiten nur in der geöffneten Seite. Es wird keine Sprachsynthese gestartet und der eingegebene Text weder versendet noch dauerhaft gespeichert.
Lädt die Seite alle Hörproben sofort?
Nein. Die Audioplayer starten nicht automatisch und laden die MP3-Dateien erst bei Bedarf zum Abspielen. Es ist kein externer Audioplayer eingebettet.
Erzeugt der Textcheck eine KI-Stimme?
Nein. Der Textcheck zählt Zeichen und markiert mögliche Prüfstellen im Text. Die vier vorhandenen Hörproben sind separat erzeugte Dateien; deine Eingabe wird nicht an einen Sprachdienst gesendet.