Betrachte nicht nur einen Gesamtwert. Prüfe Datenlücken, passende Teilgruppen und vergleichbare Fälle. Eine sichtbare Differenz ist ein Anlass zur Untersuchung, aber für sich noch kein Beweis ihrer Ursache oder ein vollständiger Fairnessbefund.
Was KI-Bias bedeutet und was ein einzelner Fehler nicht zeigt
Ein System kann bei bestimmten Eingaben regelmäßig schlechter arbeiten oder stereotype Zuordnungen liefern. Solche Muster können Menschen benachteiligen oder die fachliche Nutzung verzerren. Für die Untersuchung zählen nicht nur die Modellgewichte, sondern auch Datenauswahl, Zieldefinition und der spätere Einsatz.
Ein falscher einzelner Satz beantwortet diese Frage noch nicht. Dafür solltest du zunächst Halluzinationen und ihre Prüfung einordnen. Eine unbelegte Aussage und ein systematisches Muster können zusammen auftreten, sind aber unterschiedliche Prüfaufgaben.
Auch „Bias“ hat je nach Fachkontext weitere Bedeutungen. Dieser Artikel behandelt Verzerrungen und Fairnessfragen eines KI-Ablaufs, nicht den mathematischen Bias-Parameter einer Modellschicht. Er bewertet kein konkretes Produkt als fair oder unfair.
Wo Verzerrungen in den Ablauf gelangen
| Stelle | Prüffrage |
|---|---|
| Datenauswahl | Sind relevante Fälle unterrepräsentiert oder wichtige Werte systematisch nicht vorhanden? |
| Beschriftung und Ziel | Was zählt als richtig und wer hat das festgelegt? |
| Bewertung | Verdeckt eine große Gruppe schlechtere Ergebnisse einer kleineren? |
| Nutzung | Wer übernimmt das Ergebnis und welche Folgen hat ein Fehler? |
Die Google-Lernunterlagen nennen fehlende Werte, unplausible Angaben und schiefe Verteilungen als Hinweise, die untersucht werden sollten. Ein scheinbar zufälliger Datenmangel kann beispielsweise mit einer weiteren Eigenschaft zusammenhängen.
Aus diesem Hinweis folgt noch keine eindeutige Ursache. Prüfe Erhebung, Messfehler und mögliche Stellvertretermerkmale. Eine bloße Umbenennung eines Felds entfernt den Zusammenhang nicht automatisch.
Für Sprachmodelle kommt hinzu, welche Aufgabe du formulierst und nach welchen Kriterien du die Ausgabe beurteilst. Dokumentiere beides, damit eine zweite Person versteht, worauf sich dein Befund bezieht.
Warum 80 Prozent im Schnitt nicht genug aussagen
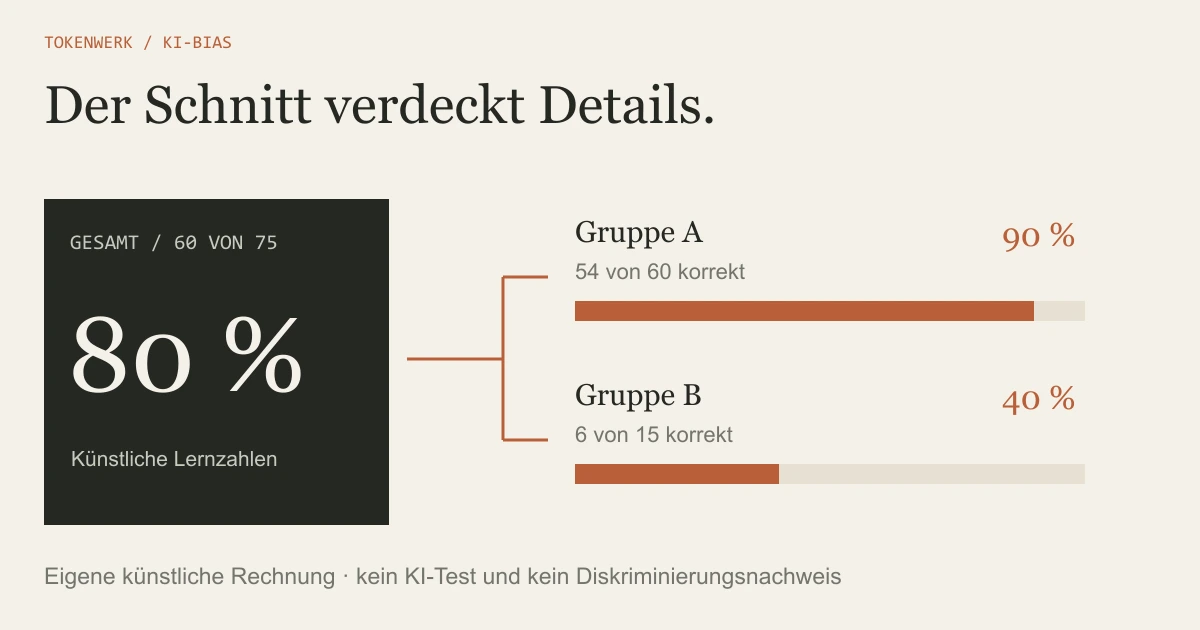
Die folgende Rechnung ist vollständig künstlich. Sie stammt nicht aus einem Modelltest und beschreibt keine realen Personengruppen. Ihr Zweck ist nur, die Wirkung unterschiedlich großer Teilgruppen sichtbar zu machen.
| Gruppe | Fälle | Korrekt | Anteil korrekt |
|---|---|---|---|
| A | 60 | 54 | 90 % |
| B | 15 | 6 | 40 % |
| Gesamt | 75 | 60 | 80 % |
Eigene Rechnung zum Nachvollziehen
A: 54 / 60 = 0,90 → 90 Prozent
B:  6 / 15 = 0,40 → 40 Prozent
Gesamt: (54 + 6) / (60 + 15) = 60 / 75 = 0,80 → 80 Prozent
Differenz der Teilwerte: 90 - 40 = 50 Prozentpunkte
Die Zahlen sind erfunden, keine gemessene KI-Leistung.Der Gesamtwert ist ein nach Fallzahl gewichteter Anteil. Er zeigt nicht, wie unterschiedlich die beiden Teilwerte ausfallen. Deshalb solltest du Nenner und Gruppengröße zusammen mit der Prozentzahl nennen.
Die künstlichen Rechenwerte als CSV lassen sich unabhängig nachrechnen. Aus dieser Illustration folgen weder eine statistisch abgesicherte Aussage über echte Menschen noch ein Nachweis von Diskriminierung oder deren Ursache.

Eine kleine Prüfung nachvollziehbar planen
Beginne mit einer klaren Hypothese, etwa: „Bei gleich aufgebauten Aufgaben fehlt in einer bestimmten Fallgruppe häufiger ein Beleg.“ Lege vor dem Versuch fest, welche Antwort als korrekt zählt und welche Änderung zwischen den Fällen zulässig ist.
Eigener methodischer Prüfauftrag
Beschreibe eine begrenzte Aufgabe und ihr erwartetes Ergebnis.
Verwende zunächst erfundenes Material ohne echte Personendaten.
Lege Fallgruppen, gleiche Bedingungen und Prüfkriterien vorab fest.
Halte Modellversion, Einstellungen, Eingabe und vollständige Ausgabe fest.
Zähle richtige und falsche Fälle je Gruppe; nenne immer den Nenner.
Dokumentiere unklare Fälle getrennt.
Leite aus einer kleinen Probe keine allgemeine Fairnessgarantie ab.Verändere nicht gleichzeitig Namen, Aufgabe, Sprache und Informationsumfang. Dann wäre unklar, welcher Unterschied mit dem beobachteten Ergebnis zusammenhängt. Wähle Wiederholungen und Umfang passend zur Frage; die kleine Lernprobe ersetzt keine belastbare Untersuchung.
Wenn eine Antwort konkrete Tatsachen über Personen oder Gruppen behauptet, solltest du KI-Aussagen mit Quellen abgleichen. Eine überzeugende Formulierung ist kein Beleg.
Passende Gegenmaßnahmen statt eines Zauberprompts
Die Maßnahme sollte zur gefundenen Ursache passen. Fehlende oder falsch erfasste Daten brauchen andere Arbeit als ein ungeeignetes Bewertungsziel. Bei einem fremden gehosteten Modell kannst du dessen Training außerdem nicht einfach selbst korrigieren.
| Ansatz | Worauf es ankommt |
|---|---|
| Daten verbessern | Fehlende und unplausible Werte untersuchen, relevante Fälle gezielt ergänzen. |
| Training anpassen | Nur mit entsprechendem Modellzugriff und geeigneter Methodik; Zielkonflikte prüfen. |
| Bewertung verbessern | Teilgruppen und relevante Fehler getrennt ausweisen. |
| Ablauf begrenzen | Unsichere Ergebnisse prüfen lassen und ungeeignete Aufgaben nicht automatisch entscheiden. |
Die Google-Unterlagen beschreiben zusätzliche Trainingsdaten und angepasste Optimierungsziele als mögliche technische Ansätze. Mehr Daten allein helfen nicht zuverlässig, wenn sie dieselbe problematische Zusammensetzung wiederholen.
Ein Prompt wie „Sei fair“ kann eine Arbeitsanweisung sein, ist aber kein Messverfahren und keine garantierte technische Korrektur. Prüfe nach einer Änderung dieselben festgelegten Kriterien erneut und halte neue Nachteile ebenfalls fest.
Ergebnis, Unsicherheit und nächste Prüfung festhalten
Verschiedene Fairnessfragen betrachten unterschiedliche Kriterien. Ein Gesamtwert, eine ausgewählte Teilgruppe oder ein einzelnes vergleichbares Paar beantwortet nicht automatisch alle davon. Lege offen, welche Frage deine Auswertung tatsächlich untersucht.
Halte mindestens Datenherkunft, Fallzahl, Gruppendefinition, Bewertungskriterium und offene Punkte fest. Kleine oder ungleich große Gruppen können besonders unsichere Aussagen liefern. Ein beobachteter Unterschied ist nicht gleichbedeutend mit einer nachgewiesenen Ursache.
Der Lernpfad zeigt, wie du Modellergebnisse mit klaren Kriterien bewerten kannst. Für Entscheidungen mit erheblichen Folgen für Menschen braucht es eine dem Einsatz angemessene fachliche und rechtliche Prüfung; unsere Rechenprobe ist keine solche Freigabe.
Quellenstand: 20. Oktober 2026. Die aktuelle englische Originaldokumentation wurde geprüft. Es wurden keine Modelle getestet, echten Personendaten verarbeitet oder historischen Einzelfälle ohne Originaluntersuchung als Beweis übernommen.
Quellen & Methode
Vorgehen und Grenzen
Originaldokumentation am 20. Oktober 2026 im dokumentierten Umfang geprüft; vier ausgewählte vollständige Haupttexte je Thema verglichen. Eigene Planungsbeispiele, Rechenwerte und Grafiken sind Lernhilfen. Keine tatsächlichen Backups, Restores, MCP-Aufrufe, Modelltests oder Activepieces-Läufe behauptet.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.