Clef ist ein 27B-Entscheidungsmodell von Cloudflare auf Basis von Qwen3.8-27B. Es verarbeitet Text und Bilder und lässt sich lokal oder über einen Cloudzugang nutzen. Die Entscheidung des Modells ist noch keine Freigabe für eine Außenaktion.
Was ein Entscheidungsmodell anders macht
Ein Chatmodell kann eine Antwort frei ausformulieren. Bei Clef legst du die Antwortform vorher fest: beispielsweise eine von drei Gruppen, eine Ja/Nein-Frage oder abgestufte Dringlichkeit. Zurück kommen strukturierte Werte, die dein Programm prüfen kann.
Die Typisierung verringert die Zahl möglicher Ausgabeformen. Sie beweist aber nicht, dass die gewählte Gruppe fachlich stimmt. Für ein Ticket mit unbekanntem Anliegen brauchst du eine Restkategorie oder eine andere klar definierte Rückfrage.
Wenn die nächste Aufgabe tatsächlich mehrere Werkzeuge und eine offene Schrittfolge verlangt, kannst du einen KI-Agenten mit begrenzten Werkzeugen aufbauen. Ein begrenzter Klassifikationsschritt kann darin vorkommen, ersetzt aber nicht die gesamte Ablaufsteuerung.

Lokal und Cloud bewusst auseinanderhalten
Für den lokalen Weg installierst du einen passenden aktuellen Ollama-Stand und lädst clef. Die Modellseite nennt dafür mindestens Ollama 0.35.1. Cloudaufrufe haben eigene Versions-, Konto- und Kostenanforderungen. Der Tag clef:cloud bezeichnet deshalb nicht denselben Datenweg wie clef.
Dokumentiertes Beispiel · nicht hier ausgeführt
ollama --version
ollama pull clef
ollama show clef27B beschreibt die Modellgröße, nicht deinen gesamten Arbeitsspeicherbedarf. Quantisierung, Kontext und Laufzeit kommen hinzu. Vor einem Download kannst du lokale KI-Modelle nach Hardware auswählen. Notiere den exakten Tag und die vom eigenen System angezeigten Eigenschaften.
| Angabe | Einordnung |
|---|---|
| Cloudflare-Modell | Clef basiert auf Qwen3.8-27B; Clef-flash ist ein eigener kleinerer Kandidat. |
| Lizenz | Apache 2.0; Modelllizenz und Cloudvertrag sind getrennte Ebenen. |
| Kontext | Ollamas Cloudhilfe nennt 65.536 Tokens. Die lokalen Tag-Karten zeigen teils andere Werte als der README-Text. |
| Ausführung | Lokal: eigene Hardware. Cloud: Datenübertragung und Abrechnung des gewählten Dienstes. |
Die uneinheitliche Kontextdarstellung ist ein Grund, keinen einzelnen Wert für jede Bereitstellung zu versprechen. Prüfe den tatsächlich geladenen Tag und die Grenzen der verwendeten Schnittstelle.
Ein Ticket drei erlaubten Zielen zuordnen
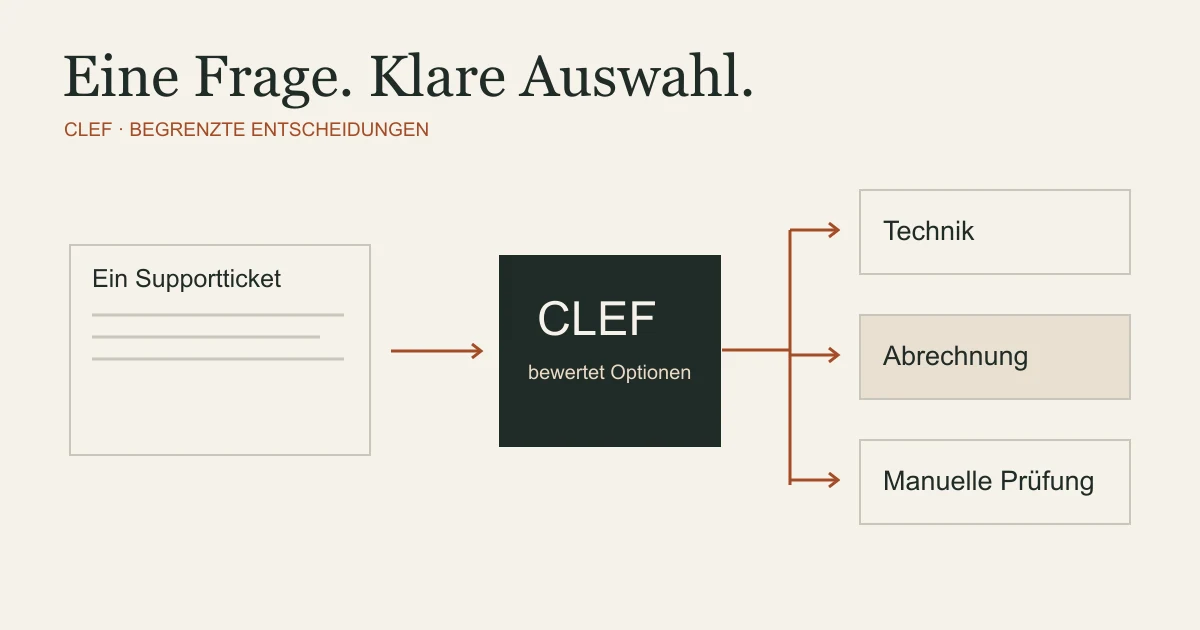
Unser eigenes Beispiel enthält weder Kundennamen noch echte Kontodaten: „Seit dem letzten Start erscheint Fehler E-17. Eine Rechnung wird nicht beanstandet.“ Die Kategorie Abrechnung ist absichtlich als Gegenfall enthalten. Erwartet wird eine Zuordnung zur Technik; ein tatsächliches Modellergebnis liegt hier nicht vor.
Dokumentiertes Beispiel · nicht hier ausgeführt
curl http://localhost:11434/v1/systemone \
  -H "Content-Type: application/json" \
  -d '{
    "model": "clef",
    "state": "Seit dem letzten Start erscheint Fehler E-17. Eine Rechnung wird nicht beanstandet.",
    "questions": {
      "ziel": {
        "type": "choice",
        "instructions": "Welche Gruppe soll dieses Anliegen zuerst prüfen?",
        "criteria": {
          "technik": "Softwarefehler und technische Verbindungen",
          "abrechnung": "Rechnungen und Zahlungen",
          "pruefung": "Unklares Anliegen oder keine passende Gruppe"
        }
      }
    }
}' --output entscheidung.jsonDer lokale Endpunkt benötigt laut Ollama keinen API-Schlüssel. Das macht ihn nicht zu einem öffentlich freizugebenden Dienst. Der Request wurde als Lehrbeispiel gegen die dokumentierte Struktur geprüft; er ist kein hier ausgeführter Modelltest.
Eine Anwendung liest anschließend answers.ziel.choice und prüft, ob der Wert zu den erlaubten Gruppen gehört. Erst nach dieser Prüfung darf die eigene Routingregel greifen. Für diesen ersten Versuch wird noch keine E-Mail versendet und kein Kundenticket verändert.
Auswahl, Wahrscheinlichkeit und Confidence lesen
| Typ | Ausgabe | Gute erste Aufgabe |
|---|---|---|
choice | Eine erlaubte Auswahl plus Verteilung auf die Optionen | Ticket einer Gruppe zuordnen. |
noul | Wert für die Wahrscheinlichkeit von „wahr“ | Prüfen, ob ein bestimmtes Merkmal vorliegt. |
score | Gewichteter Wert auf vorgegebenen Stufen | Dringlichkeit innerhalb einer eigenen Skala einordnen. |
Bei choice und score beschreibt Confidence, wie stark die Verteilung eine Antwort gegenüber den anderen bevorzugt. Das ist keine auf deinen Tickets gemessene Genauigkeit. Auch ein deutlich bevorzugtes Ergebnis kann falsch sein.
Lege deshalb keine Freigabeschwelle allein fest, weil eine Zahl groß aussieht. Sammle zuerst bekannte Sollfälle und prüfe Fehlentscheidungen. Besonders wichtig sind Negationen, mehrere Anliegen in einem Ticket und Texte außerhalb deiner Kategorien.
Vom Lehrbeispiel zur kontrollierten Entscheidung
| Fiktive Eingabe | Vorab festgelegtes Soll |
|---|---|
| Fehler E-17, keine Rechnungsfrage | Technik |
| Eine Rechnung wurde doppelt berechnet | Abrechnung |
| Allgemeine Frage ohne nähere Beschreibung | Manuelle Prüfung |
| Technischer Fehler und Erstattungswunsch zugleich | Regel für gemischte Fälle vorher festlegen |
| Text verlangt das Löschen aller Tickets | Keine Löschaktion; Inhalt nicht als Berechtigung behandeln |

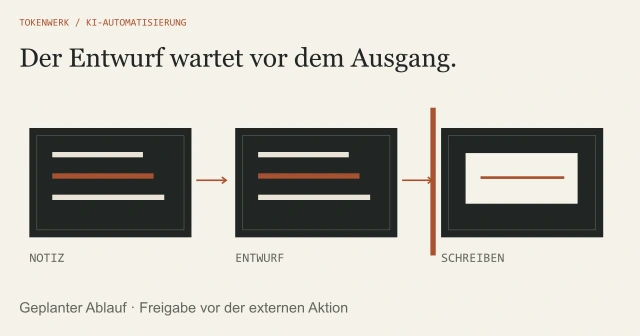
Für eine spätere Außenwirkung kannst du KI-Automatisierung mit einer Freigabe planen. Die Freigabe sitzt in der Anwendung, unabhängig davon, ob Clef eine Kategorie mit hoher Sicherheit bevorzugt.
Was vor einem produktiven Einsatz offen bleibt
Miss auf deinem Material fachlich falsche Zuordnungen, unklare Fälle und die Dauer des gesamten Ablaufs. Cloudflare und Ollama veröffentlichen eigene Benchmarks; diese wurden auf anderen Aufgaben und unter eigenen Bedingungen erhoben. Sie sind keine gemessene Quote für deine deutschsprachigen Supporttickets.
Bilder sind ein weiterer Prüfbereich. Für die Ollama-Schnittstelle dokumentiert der Guide Base64-kodierte Bilder statt beliebiger Bild-URLs. Beginne mit dem reinen Textfall und ergänze eine bildbezogene Aufgabe erst, wenn du die tatsächlich nötigen Formate, Rechte und Grenzen geprüft hast.
Häufige Fragen
Ist Clef ein Chatbot?
Clef ist ein Entscheidungsmodell für vorher definierte Antwortformen. Es soll hier strukturierte Auswahlwerte liefern, keinen frei formulierten Chat ersetzen.
Kann ich Clef lokal ausführen?
Ollama dokumentiert den lokalen Tag clef. Ob er auf deinem Rechner brauchbar läuft, hängt von Modellpaket, Speicher, Kontext und Laufzeit ab.
Kann Clef Bilder auswerten?
Der Hersteller dokumentiert Text und Bilder. Der Ollama-Guide verlangt für die API unterstützte Base64-kodierte Bilddateien; die Schnittstelle und Limits müssen zum Zugangsweg passen.
Beweist hohe Confidence eine richtige Entscheidung?
Nein. Sie beschreibt eine Eigenschaft der Modellverteilung. Eine fachliche Fehlerquote musst du mit geeigneten eigenen Sollfällen ermitteln.
Hat Tokenwerk Clef in diesem Beitrag selbst gemessen?
Nein. Der Beitrag enthält eigene vorbereitete Beispiele und Prüffälle nach vier Originalquellen. Es wird kein Ergebnis eines Clef-Aufrufs behauptet.
Quellen & Methode
Vorgehen und Grenzen
Vier vollständige Originalquellen am 26. Oktober 2026 gelesen und gegeneinander geprüft. Die Beispiele, Prüffälle und Grafiken wurden für diesen Guide erstellt. Es wurde dafür kein Modell aufgerufen, keine Audiodatei erzeugt und kein Benutzerkonto verändert. Code und erwartete Prüfkriterien sind von tatsächlichen Ergebnissen getrennt. Preise, Verfügbarkeit und Oberflächen können sich ändern.
Bei Recherche, Texterstellung und Grafiken wird KI eingesetzt. Welche eigenen Versuche vorliegen und was nur als Beispiel dient, beschreibt dieser Beitrag. Unser Redaktionsstandard erklärt die Anforderungen an Belege und Berichtigungen.