Code & Agenten
MiniMax M3.1 Flash
MiniMax M3.1 Flash ist ein multimodales Coding-Modell mit Thinking. Die aktuelle API-ID lautet MiniMax-M3.1-Flash; diese URL stammt aus der Preview-Phase.
Technologie verstehen.
Besser entscheiden.
 Code & Agenten
MiniMax M3 verarbeitet Text, Bilder und Video und erzeugt Text für Coding- und Agentenaufgaben. Die direkte API-ID lautet MiniMax-M3; M3.1 Flash ist eine andere Version.
Für dieses Modell gelten Zugangsbeschränkungen. Kläre die Freigabe beim Anbieter, bevor du einen API-Aufruf oder eine Installation planst.
Aktuell im HerstellerkatalogQuellenstand 2026-10-23
MiniMax im Verzeichnis
Identität, Funktionen und Betrieb getrennt lesen. Die Angaben beziehen sich auf diese konkrete Version.
„Nicht bestätigt“ kennzeichnet eine offene Angabe. Es bedeutet weder „nicht vorhanden“ noch „unbegrenzt“.
| Hersteller | MiniMax |
|---|---|
| Modellfamilie | M3 |
| Modell-/API-ID | MiniMax-M3 |
| Status | Aktuell im Herstellerkatalog |
| Modellart | Code & Agenten |
|---|---|
| Eingabe | Text, Bild, Video |
| Ausgabe | Text |
| Kontext | 1.000.000 Tokens |
|---|---|
| Maximaler Output / Horizont | 524.288 Tokens · OpenAI-kompatible Chat-Referenz |
| Bereitstellung | Direkte MiniMax-API; Konto und Freigabe prüfen |
|---|---|
| Gewichte | Nicht bestätigt |
| Lizenz | Konkrete Modell-Lizenz bzw. Anbieterbedingungen prüfen |
Die Grafik zeigt die im Profil dokumentierten Grenzen. Kontext und maximale Ausgabe sind keine addierbaren Budgets und keine Qualitätsbewertung. Zusätzliche Bedingungen stehen im Datenblatt.
Datenbasis: Herstellerangaben im Quellenstand 2026-10-23. Quellen zu diesem Profil ↓

Nutze ein kleines, isoliertes Beispiel mit erwarteten Ergebnissen und vorhandenen Tests. Prüfe den Code und die Änderungen, bevor du ihn ausführst. Der Guide zu KI-Coding-Tools zeigt, wie du sichtbare Änderungen, Tests und Dateizugriff in einen nachvollziehbaren Werkzeugvergleich einbeziehst.
Prüfe vor einem API-Aufruf, ob dein Konto Zugriff hat und welchen Endpunkt, Tarif und welche Region du verwenden musst. Notiere die genaue Modellversion. Ein Kurzname in der API kann später auf einen anderen Modellstand verweisen.
Leistung: Wir haben die Leistung dieses Modells hier nicht selbst gemessen. Nutze die Aufgabe unten, um es an deinen Anforderungen zu prüfen.
Oberhalb 512k Eingabetokens: 0,60 / 2,40 USD. Cache-Lesen: 0,06 bzw. 0,12 USD je Million Tokens. Priority kostet 1,5-mal Standard. Konto, Werkzeuge und Steuerbedingungen separat prüfen.
Zugang: Direkte MiniMax-API; Konto und Freigabe prüfen. Prüfe vor einer Integration die für dein Konto und deine Region verfügbaren Endpunkte. Ein Eintrag im öffentlichen Katalog ist keine Bestätigung eines freigeschalteten Kontos.
Geprüft am 23. Oktober 2026. Herstellerangaben und eigene Rechenbeispiele; kein ausgeführter Modelltest.
Die MiniMax-Preisseite trennt Standard und Priority sowie zwei Bereiche für die Eingabelänge. Übertrage einen Preis eines Vermittlers oder eines Abos nicht ungeprüft auf deinen direkten API-Zugang. Die Tabelle nennt USD je Million Tokens im am Prüftag ausgewiesenen Tarif.
| Zugang und Eingabelänge | Input | Output | Cache-Lesen |
|---|---|---|---|
| Standard · bis 512k | 0,30 | 1,20 | 0,06 |
| Standard · über 512k | 0,60 | 2,40 | 0,12 |
| Priority · bis 512k | 0,45 | 1,80 | 0,09 |
| Priority · über 512k | 0,90 | 3,60 | 0,18 |
Die Grenze ist hier mit dem Herstellerlabel 512k wiedergegeben. Ein großes Kontextfenster und ein günstiger Einstiegspreis bedeuten keinen einheitlichen Tarif für jede Eingabelänge. Der allgemeine Tokenwerk-Rechner ist für dieses Profil vorerst nicht freigeschaltet, damit er keine ungeprüfte numerische Grenzinterpretation verwendet.

| Annahme pro Anfrage | Rechnung in USD | Ergebnis |
|---|---|---|
| Standard: 10.000 Input, 2.000 Output | 10.000 × 0,30 / 1 Mio. + 2.000 × 1,20 / 1 Mio. | 0,0054 USD |
| Priority: dieselben angenommenen Tokens | 0,0054 × 1,5 | 0,0081 USD |
| Standard: 600.000 Input, 2.000 Output | 600.000 × 0,60 / 1 Mio. + 2.000 × 2,40 / 1 Mio. | 0,3648 USD |
Dies sind nachgerechnete Annahmen, keine beobachtete Rechnung. Setze in einem eigenen Kostenblatt die tatsächlich abgerechneten Mengen ein. Insbesondere darfst du bei aktiviertem Thinking nicht allein die sichtbaren Antwortzeichen als Outputverbrauch zählen.
Du brauchst einen für dich verfügbaren MiniMax-API-Zugang, Guthaben nach den aktuellen Bedingungen und Python 3. Lege deinen Schlüssel über die Umgebungsvariable MINIMAX_API_KEY deiner eigenen Arbeitsumgebung bereit. Speichere ihn nicht im Quellcode, in Screenshots oder öffentlichen Vorlagen.
Die Vorlage verwendet nur künstliche Daten, schaltet für M3 Thinking aus und begrenzt die Ausgabe auf 1.024 Tokens. Der Code wird auf dieser Website nicht ausgeführt. Erst dein eigener Start sendet Daten an MiniMax und kann Kosten auslösen. Die Chat-Referenz bestätigt Endpunkt und Parameter.
import json
import os
import urllib.request

# Beispiel: eigener Start sendet die Anfrage an MiniMax und kann Kosten verursachen.
api_key = os.environ["MINIMAX_API_KEY"]
payload = {
    "model": "MiniMax-M3",
    "service_tier": "standard",
    "thinking": {"type": "disabled"},
    "max_completion_tokens": 1024,
    "messages": [{"role": "user", "content":
        "Erkläre an einem eigenen Beispiel den Unterschied zwischen 2 und false in JSON."}]
}
request = urllib.request.Request(
    "https://api.minimax.io/v1/chat/completions",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Authorization": "Bearer " + api_key,
             "Content-Type": "application/json"},
    method="POST"
)
with urllib.request.urlopen(request, timeout=60) as response:
    result = json.load(response)
print("Modell:", result.get("model"))
print(result["choices"][0]["message"].get("content", ""))
print("Verbrauch:", result.get("usage"))
Python-Vorlage herunterladen. Speichere sie beispielsweise als minimax-m3-einstieg.py und starte sie in deiner vorbereiteten Umgebung mit python minimax-m3-einstieg.py. Vergleiche danach angefragte und zurückgemeldete Modell-ID sowie usage.
Für M3 gilt die ID MiniMax-M3. Die aktuelle SDK-Dokumentation beschreibt bei M3 einen abschaltbaren Thinking-Modus. M3.1 Flash verlangt Thinking und kennt eine regelbare Thinking-Tiefe. Kopiere dessen reasoning_effort-Beispiele deshalb nicht als vermeintlichen M3-Funktionsnachweis. Laut derselben Referenz haben übergebene temperature-Werte für diese Modelle derzeit keine Wirkung.
M3 kann visuelle Eingaben verarbeiten, erzeugt in diesem Profil aber Text. Ein Video lesen und ein Video erzeugen sind unterschiedliche Aufgaben. Die H3-Reihe ist im Herstellerkatalog gesondert aufgeführt. Auch Gewichte und eine konkrete lokale Nutzungslizenz werden durch diese API-Vorlage nicht nachgewiesen.
| Beobachtung | Nächste Prüfung |
|---|---|
| Authentifizierung abgelehnt | Ist die Umgebungsvariable in genau diesem Prozess vorhanden? Gehören Schlüssel und Endpunkt zu deinem MiniMax-Zugang? Keine Schlüssel in Fehlermeldungen veröffentlichen. |
| Modell oder Parameter abgelehnt | Exakte Modell-ID und aktuelle Konto-Freigabe prüfen. M3- und M3.1-Parameter nicht vermischen. |
| Antwort abgeschnitten oder kein finaler Text | finish_reason, Thinking-Modus und max_completion_tokens prüfen. Das dokumentierte Maximum 524.288 ist keine Vorgabe, jeden Versuch so groß zu starten. |
| Kosten anders als erwartet | Service-Tier, gesamte Eingabelänge, Cache, abgerechnete Ausgabe und zusätzliche Werkzeuge gegen den aktuellen Tarif abgleichen. |
Praxisergänzung geprüft am 23. Oktober 2026 · eigene Aufgabe, kein Modellbenchmark
Beim Übernehmen von JSON-Daten reicht ein Blick auf die Zahl nicht. Ein boolescher Wert und eine Zeichenfolge müssen unter Umständen anders behandelt werden als eine echte Ganzzahl. Unsere Coding-Aufgabe definiert deshalb einen strengen Vertrag. Lass dir zunächst die erwarteten Ergebnisse erläutern, bevor du einen Implementierungsvorschlag selbst prüfst und ausführst.
MiniMax führt MiniMax-M3 im aktuellen Katalog als multimodales Coding-Modell. Die Dokumentation verwendet inzwischen häufig MiniMax-M3.1-Flash in Beispielen; diese neue ID ist nicht dieselbe Version. Halte für diesen Versuch den tatsächlich verfügbaren Zugang und die gewählte Modell-ID fest. Die Vorlage ist ein Textauftrag ohne Werkzeugaufrufe und behauptet keinen ausgeführten API- oder Code-Test.
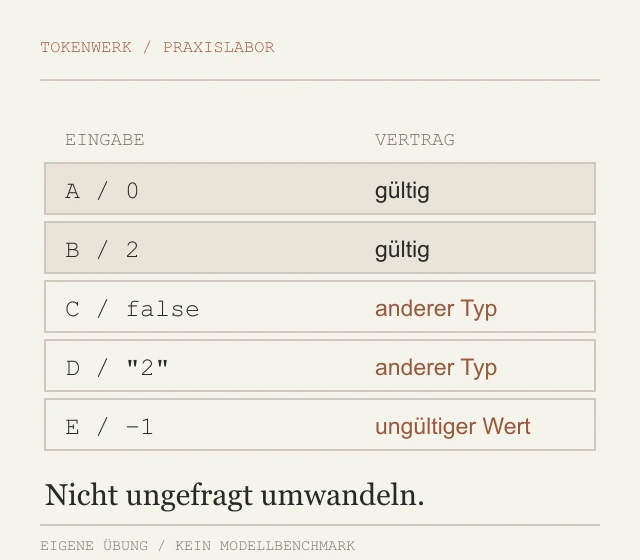
Halte Modellversion, gewählten Zugang und Einstellungen fest. Nutze nur die fiktiven Angaben dieser Vorlage.
Bearbeite die Aufgabe und speichere den geforderten JSON-Teil unverändert als antwort.json. Bei einer freien Antwort erstellst du den Prüfteil selbst und kennzeichnest das.
Vergleiche mit dem Soll und prüfe mindestens einen veränderten Eingabefall. Ein bestandener Beispielsatz ersetzt keine Abnahme auf deinen eigenen Daten.
Die Angaben sind fiktiv. Speichere den geforderten JSON-Teil der Antwort separat als antwort.json; zusätzliche Erklärungen gehören in eine andere Datei.
Entwirf eine Python-Prüfung für Mengen aus JSON. Zulässig sind ausschließlich nichtnegative Ganzzahlen. Boolesche Werte sind ausdrücklich unzulässig; Zahlentexte nicht umwandeln. Eingabefälle:
A: 0
B: 2
C: false
D: "2"
E: -1
Gib zuerst einen kurzen Implementierungsvorschlag. Danach separat JSON: gueltig (sortierte IDs), ungueltig (sortierte IDs), summe_gueltiger_mengen (Ganzzahl). Der lokale Prüfer bewertet nur dieses Soll-JSON, nicht den erzeugten Code.Vorlage herunterladenLokalen JSON-Prüfer herunterladen
{
  "gueltig": [
    "A",
    "B"
  ],
  "ungueltig": [
    "C",
    "D",
    "E"
  ],
  "summe_gueltiger_mengen": 2
}Das Soll ist redaktionell aus der Vorlage abgeleitet, keine aufgezeichnete Modellantwort. Der lokale Prüfer vergleicht die festgelegten Felder und führt keinen generierten Code oder API-Aufruf aus. Er bewertet keine freien Begründungen.
Speichere Prüfer und deine Antwort im selben Ordner. Mit installiertem Python: python pruefen.py antwort.json.
| Beobachtung | Was du prüfst |
|---|---|
| C wird als gültig eingestuft | Prüfe den Unterschied zwischen einem booleschen Wert und einer Zahl in deiner Sprache. |
| D wird ungefragt zu 2 | Automatische Typumwandlung widerspricht hier dem vorgegebenen Vertrag. |
| Alle Sollwerte stimmen, aber der Code scheitert | Das JSON prüft Erwartungen. Den Code musst du separat gegen die Fälle ausführen. |
Wie du Vorschlag und Ausführung trennst, lernst du unter Codeänderungen mit festen Prüffällen entwickeln.
Wenn solche Werte durch einen Workflow laufen, hilft dir Datentypen in n8n Expressions prüfen beim Unterscheiden von Text, Zahl und fehlender Angabe.
Gezielte Praxisergänzung auf Basis aktueller Herstellerunterlagen. Der Datenstand der bisherigen Modell-Faktentabellen bleibt separat ausgewiesen. Neue Beispiele und Grafiken sind eigene Erklärungen; es wurden keine Modellantworten oder Leistungswerte gemessen.
Herstellerunterlagen zur Ergänzung: Models - MiniMax API Docs (Abruf 2026-10-22) · Create Chat Completion - MiniMax API Docs (Abruf 2026-10-22).
Quellenstand: 2026-10-23. Spezifikationen, Tarife und Zugang können sich ändern. Die Illustration zeigt den dokumentierten Datenweg, keine gemessene Leistung.
MiniMax M3 verarbeitet Text, Bilder und Video und erzeugt Text für Coding- und Agentenaufgaben. Die direkte API-ID lautet MiniMax-M3; M3.1 Flash ist eine andere Version. Hersteller: MiniMax. Dokumentierte ID: MiniMax-M3.
Eingabe: Text, Bild, Video. Ausgabe: Text. Maßgeblich sind die Funktionen des konkreten Endpunkts in der Herstellerquelle.
Der dokumentierte Zugang lautet: Direkte MiniMax-API; Konto und Freigabe prüfen. Öffentlich verfügbare offene Gewichte werden damit nicht bestätigt. Ein integriertes On-Device-Modell kann besondere Hardware und Plattformvorgaben haben.
Standard bis 512k Eingabetokens: 0,30 / 1,20 USD je 1 Mio. Input-/Output-Tokens. Oberhalb 512k Eingabetokens: 0,60 / 2,40 USD. Cache-Lesen: 0,06 bzw. 0,12 USD je Million Tokens. Priority kostet 1,5-mal Standard. Konto, Werkzeuge und Steuerbedingungen separat prüfen. Bei selbst betriebenen Gewichten kommen Hardware- und Betriebskosten hinzu.
Nein. Das Profil dokumentiert Herstellerangaben mit Quellenstand 2026-10-23. Die Testidee ist redaktionell formuliert und wurde hier nicht ausgeführt; sie ist keine Qualitätsgarantie.
Im dokumentierten Quellenstand: 1.000.000 Tokens. Beachte die Bedingungen der konkreten Modellversion und des verwendeten Endpunkts. Kontext ist keine Wortzahl und kein Nachweis, dass jede enthaltene Information zuverlässig verarbeitet wird.
Lege eine kleine Aufgabe mit bekanntem oder nachprüfbarem Ergebnis fest. Notiere Version, Eingabe und Einstellungen. Vergleiche die Ausgabe mit deinem Prüfkriterium und halte Fehler sowie tatsächliche Kosten getrennt fest. Die Testidee auf dieser Seite ist ein Vorschlag und wurde hier nicht als Modelltest ausgeführt.
Nein. Die Modell-IDs unterscheiden sich. Dokumentationsbeispiele für eine neue Version sind kein Nachweis, dass du gerade das ältere Modell aufrufst.
Nein. Sie zeigt die Vorlage und einen lokalen JSON-Prüfer. Der Prüfer führt keinen generierten Code und keine Modellanfrage aus.
Der Übungsvertrag erlaubt ausdrücklich nur nichtnegative Ganzzahlen und schließt boolesche Werte aus. Diese Fachregel muss die Implementierung zusätzlich zum Sprachverhalten abbilden.
Laut Hersteller kostet Standard bis 512k Eingabetokens 0,30 USD Input und 1,20 USD Output je Million Tokens. Darüber gelten 0,60 und 2,40 USD. Priority ist 1,5-mal so teuer; Cache, Werkzeuge und konkrete Abrechnung gesondert prüfen. Stand: 23.10.2026.
Dieses M3-Profil dokumentiert Text, Bilder und Video als Eingaben und Text als Ausgabe. Die H3-Reihe ist ein anderes Produkt für Videogenerierung. Videoeingabe und Videoausgabe sind nicht dasselbe.
Die aktuelle OpenAI-kompatible MiniMax-Referenz beschreibt thinking.type disabled für M3. M3.1 Flash unterstützt das Abschalten nicht; dessen reasoning_effort regelt stattdessen die Tiefe.
Die geprüfte Chat-Referenz nennt 524.288 Tokens als maximales max_completion_tokens-Budget für M3. Ein Limit ist keine Zusage für eine bestimmte Antwortlänge. Kontobedingungen und Kontextbudget müssen ebenfalls passen.
Code & Agenten
MiniMax M3.1 Flash ist ein multimodales Coding-Modell mit Thinking. Die aktuelle API-ID lautet MiniMax-M3.1-Flash; diese URL stammt aus der Preview-Phase.